三十秒版本:全文在讲什么
作者 Anshu Chimala 曾在苹果领导了 12 年面向未来 AI 产品的研究与原型团队。他发现大多数人抱怨「AI 不懂设计」,其实是用错了方式:LLM 天生是「取悦所有人的委员会」,而好设计恰恰是反共识、反平均的。
他的解法不是换模型,而是换流程——把设计界经典的双钻模型(Double Diamond)改造成给 AI Agent 团队用的三阶段流水线:
从模型外部注入随机性与品味,跳出「平均脸」,探索大胆的方向。
用独立的「设计批评家」Agent 闭环迭代,再接入图像/视频生成,赋予作品个性。
靠人的判断做减法:删掉 AI 堆砌的冗余,收敛到克制、高级的成品。
病因诊断:AI 设计为什么天然「泔水」
作者给出的解释值得每个用 AI 做东西的人记住:LLM 是逐 token 预测的机器。每做一个设计决策——选什么颜色、怎么排版——它都在挑「最可能让所有人满意」的那个 token。再加上人类反馈强化学习(RLHF)的调教,模型被训练成做「一致的、安全的选择」。
结果就是「终极版委员会设计」:每个局部都不出错,合起来毫无个性。
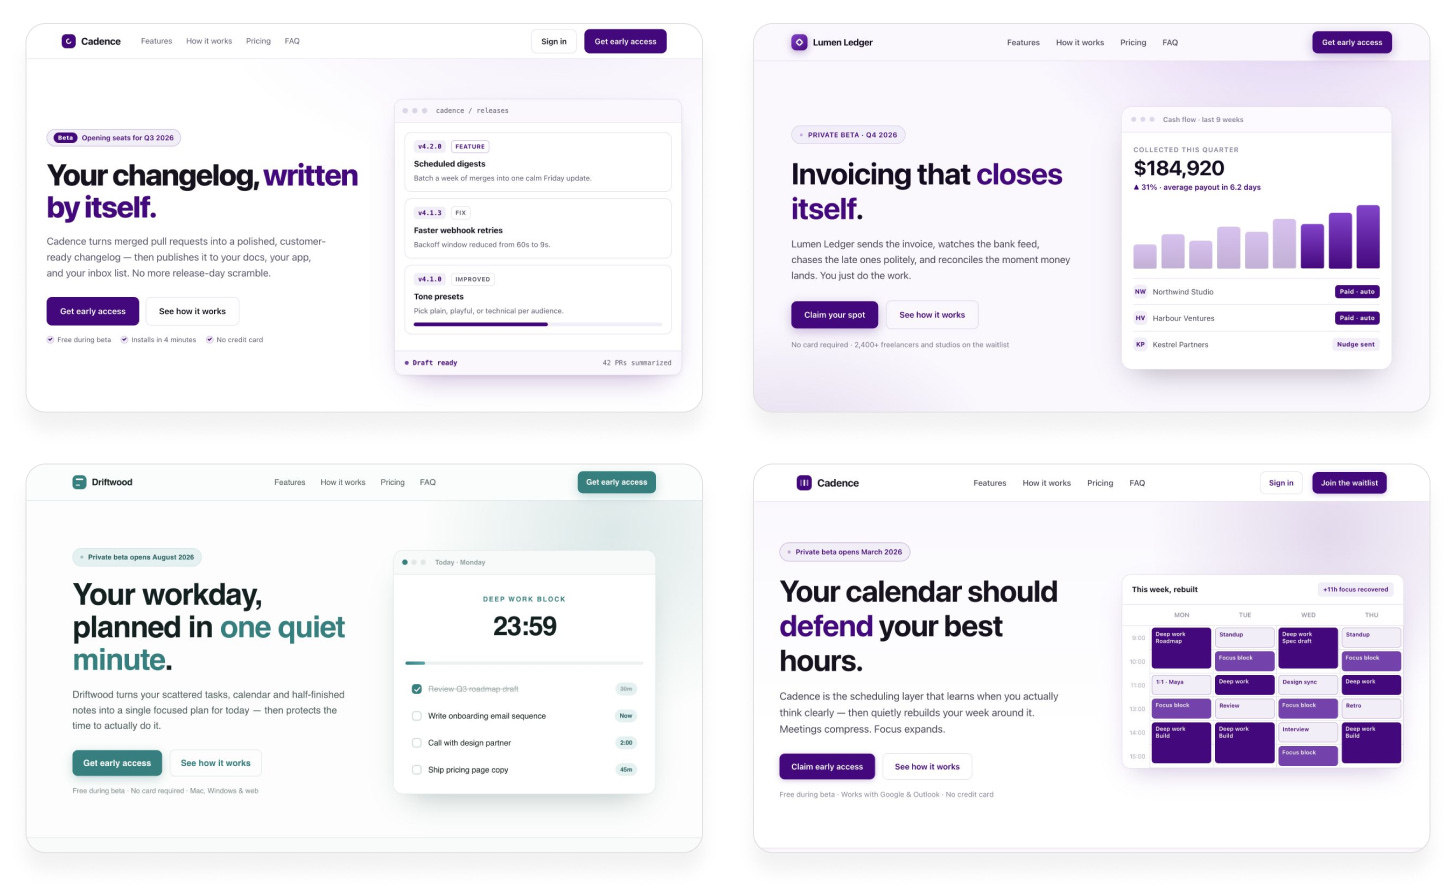
更反直觉的是:你让模型「随机一点」也没用。作者让它「每个设计决策完全随机」,输出看着不同,细看还是同一套配色、同一套结构、甚至同样蹩脚的陶艺隐喻——因为模型只能预测「听起来像随机的 token」,它骨子里不会真的随机。
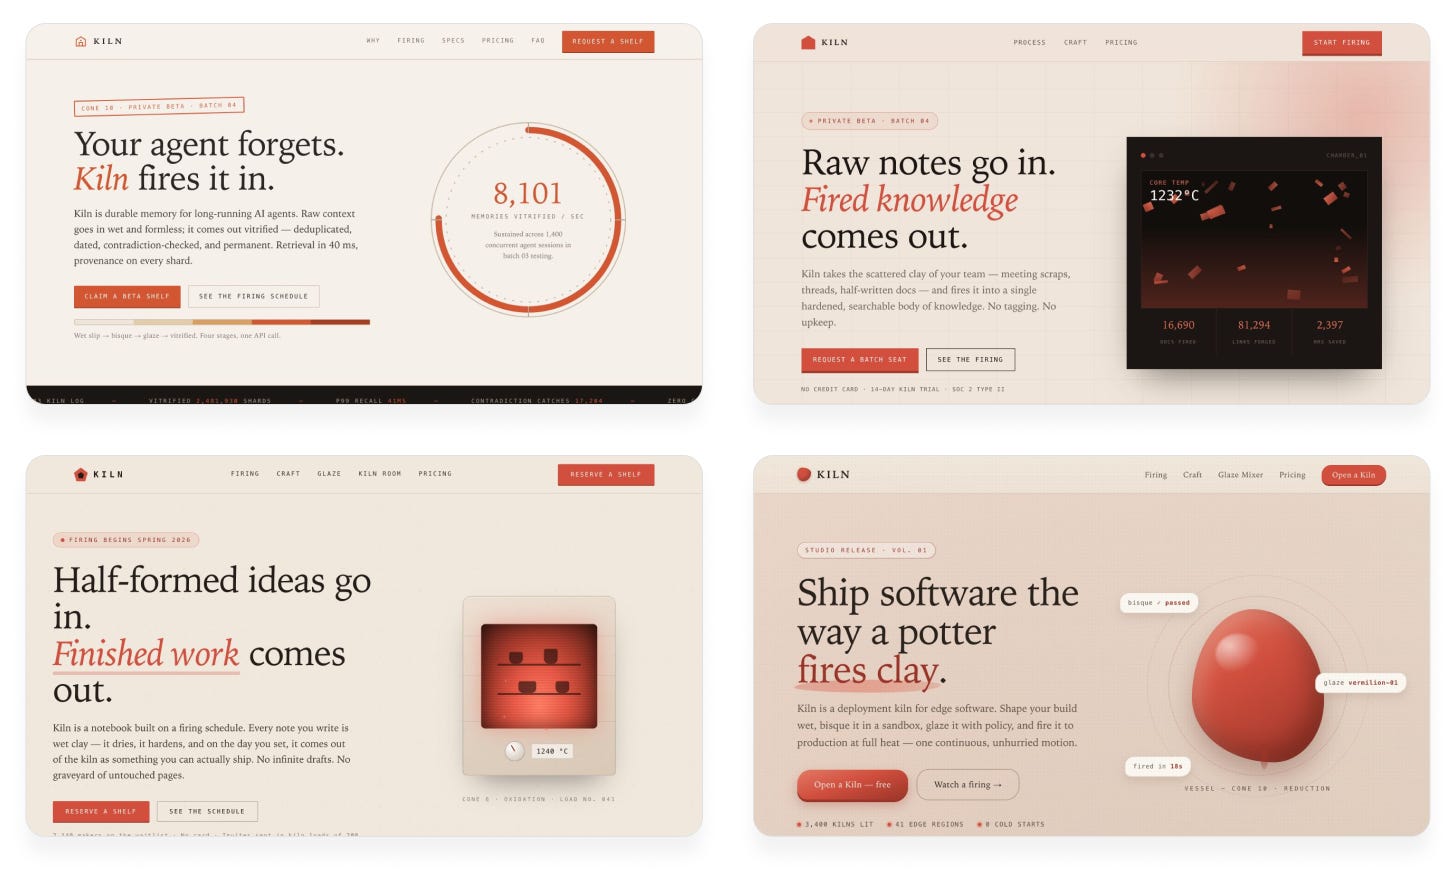
延伸解读 · 这是「分布坍缩」问题
- 技术上这叫 mode collapse / 分布收敛:RLHF 与「讨好多数评分员」的目标函数,会把输出概率质量压向分布的峰值区域,牺牲长尾的多样性。
- 所以作者全部技巧的共同本质只有一句话:多样性必须从模型外部注入——无论是外部随机种子、外部批评者,还是人类的品味。模型内部不存在真正的熵源。
- 这也解释了「调 temperature」为何不够:采样温度只影响抖动幅度,不改变模型「想去哪儿」;它仍然在同一个均值盆地附近打转。
Discover:从外部注入「熵」与「品味」
技巧 1 · 随机种子思维(String Seed of Thought)
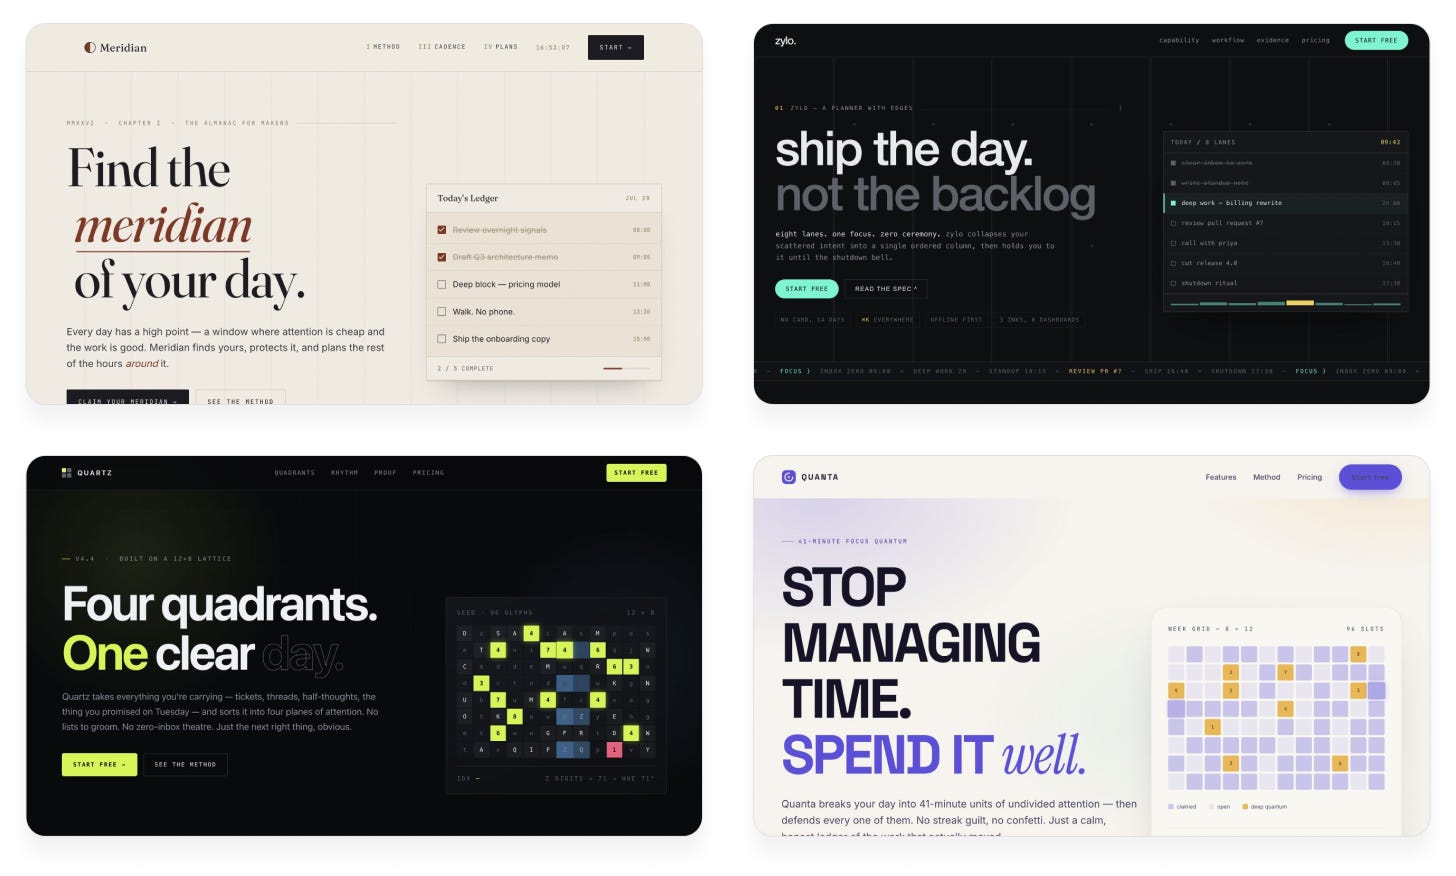
这是全文含金量最高的一个技巧,来源是日本 Sakana AI 发表的论文 SSoT。做法分两步:先让 AI 用 shell 脚本生成一串真随机字符串,再让它把这串字符串「解读」成设计灵感(找子模式、特殊数字、任何能联想到的东西),最后据此做设计。
扩展检索 · SSoT 的论文背景
- Sakana AI 的原始研究问题是:「LLM 能在脑子里抛硬币吗?」——让前沿模型抛 1000 次硬币,正反面计数严重偏离 500:500,存在系统性偏差。
- 结论:直接让 LLM 执行概率性指令时,它们无法忠实地从目标分布采样;而「先生成随机字符串、再基于它推理」这一纯 prompt 技巧(无需训练、无需外部工具)能显著提升概率忠实度与输出多样性。
- 设计领域的应用正是把这个结论推到底:既然模型内部没有随机性,就用 shell 命令把真随机喂给它。这是「工具调用补全模型能力缺口」的一个教科书案例。
技巧 2 · 狂野而具体的 prompt(注入你的品味)
第二条路是反过来——不靠随机,靠极度具体。给模型一个清晰的视觉世界观,让它有据可依,而不是临场发挥。作者的三个示范方向:
- 像素艺术:「每一屏都像一帧游戏画面,但整体仍是一个能用的落地页。」
- 等距 3D 城市:「每个产品功能对应一个街区或建筑。」
- 反规则:「激进的不对称布局、不和谐的色彩与字体、令人不适的负空间——打破一切规则,但仍要好看。」
而当你自己也没想法时,作者给出一个「找想法」的三步工作流:
| 步骤 | 做法 | 为什么有效 |
|---|---|---|
| ① 广撒网 | 让 AI 列出尽可能多的设计语言方向,「要广,不要深」 | AI 擅长穷举平庸选项,把它当菜单而不是答案 |
| ② 用你的品味锐化 | 挑一个方向,写下你的具体好恶:「我想要触感、咔哒作响的按钮;灰色渐变太无聊;避免卡通化的拟物,那很俗」 | 这一步是护城河——AI 想法人人可得,你的品味人人不同 |
| ③ 转成执行 prompt | 让 AI 把锐化后的方向写成给 coding agent 的简洁 POC prompt | 把「品味」固化成可复现的指令 |
作者的心法
- 「如果你觉得一个想法听起来肯定行不通——那你就找对方向了。」Agent 经常给你惊喜,你多半低估了它。
- 失败的 prompt 不要删:存起来,等新模型发布再跑一遍——这是检验「你是否吃透了最新模型能力」的现成测试集。
Define:设立一个不吃「沉没成本」的设计总监
即使探索阶段做得再好,初稿仍然是「有潜力的平庸」。迭代是必须的,但让写代码的 Agent 自己审自己没用——它不客观:它看着自己的代码、自己过去的决策和理由长大,无法跳出来「think different」。
作者的解法是组织设计级别的:引入第二个 Agent——「设计批评家」(design critic)。它只看截图,不看代码、不看实现、不看历史,只回答一个问题:这达到顶级设计工作室的水准了吗?打 1~10 分。执行 Agent 必须迭代到批评家独立打出 9 分以上为止——而这个标准不写进批评家的 prompt 里,保证评分不被污染。
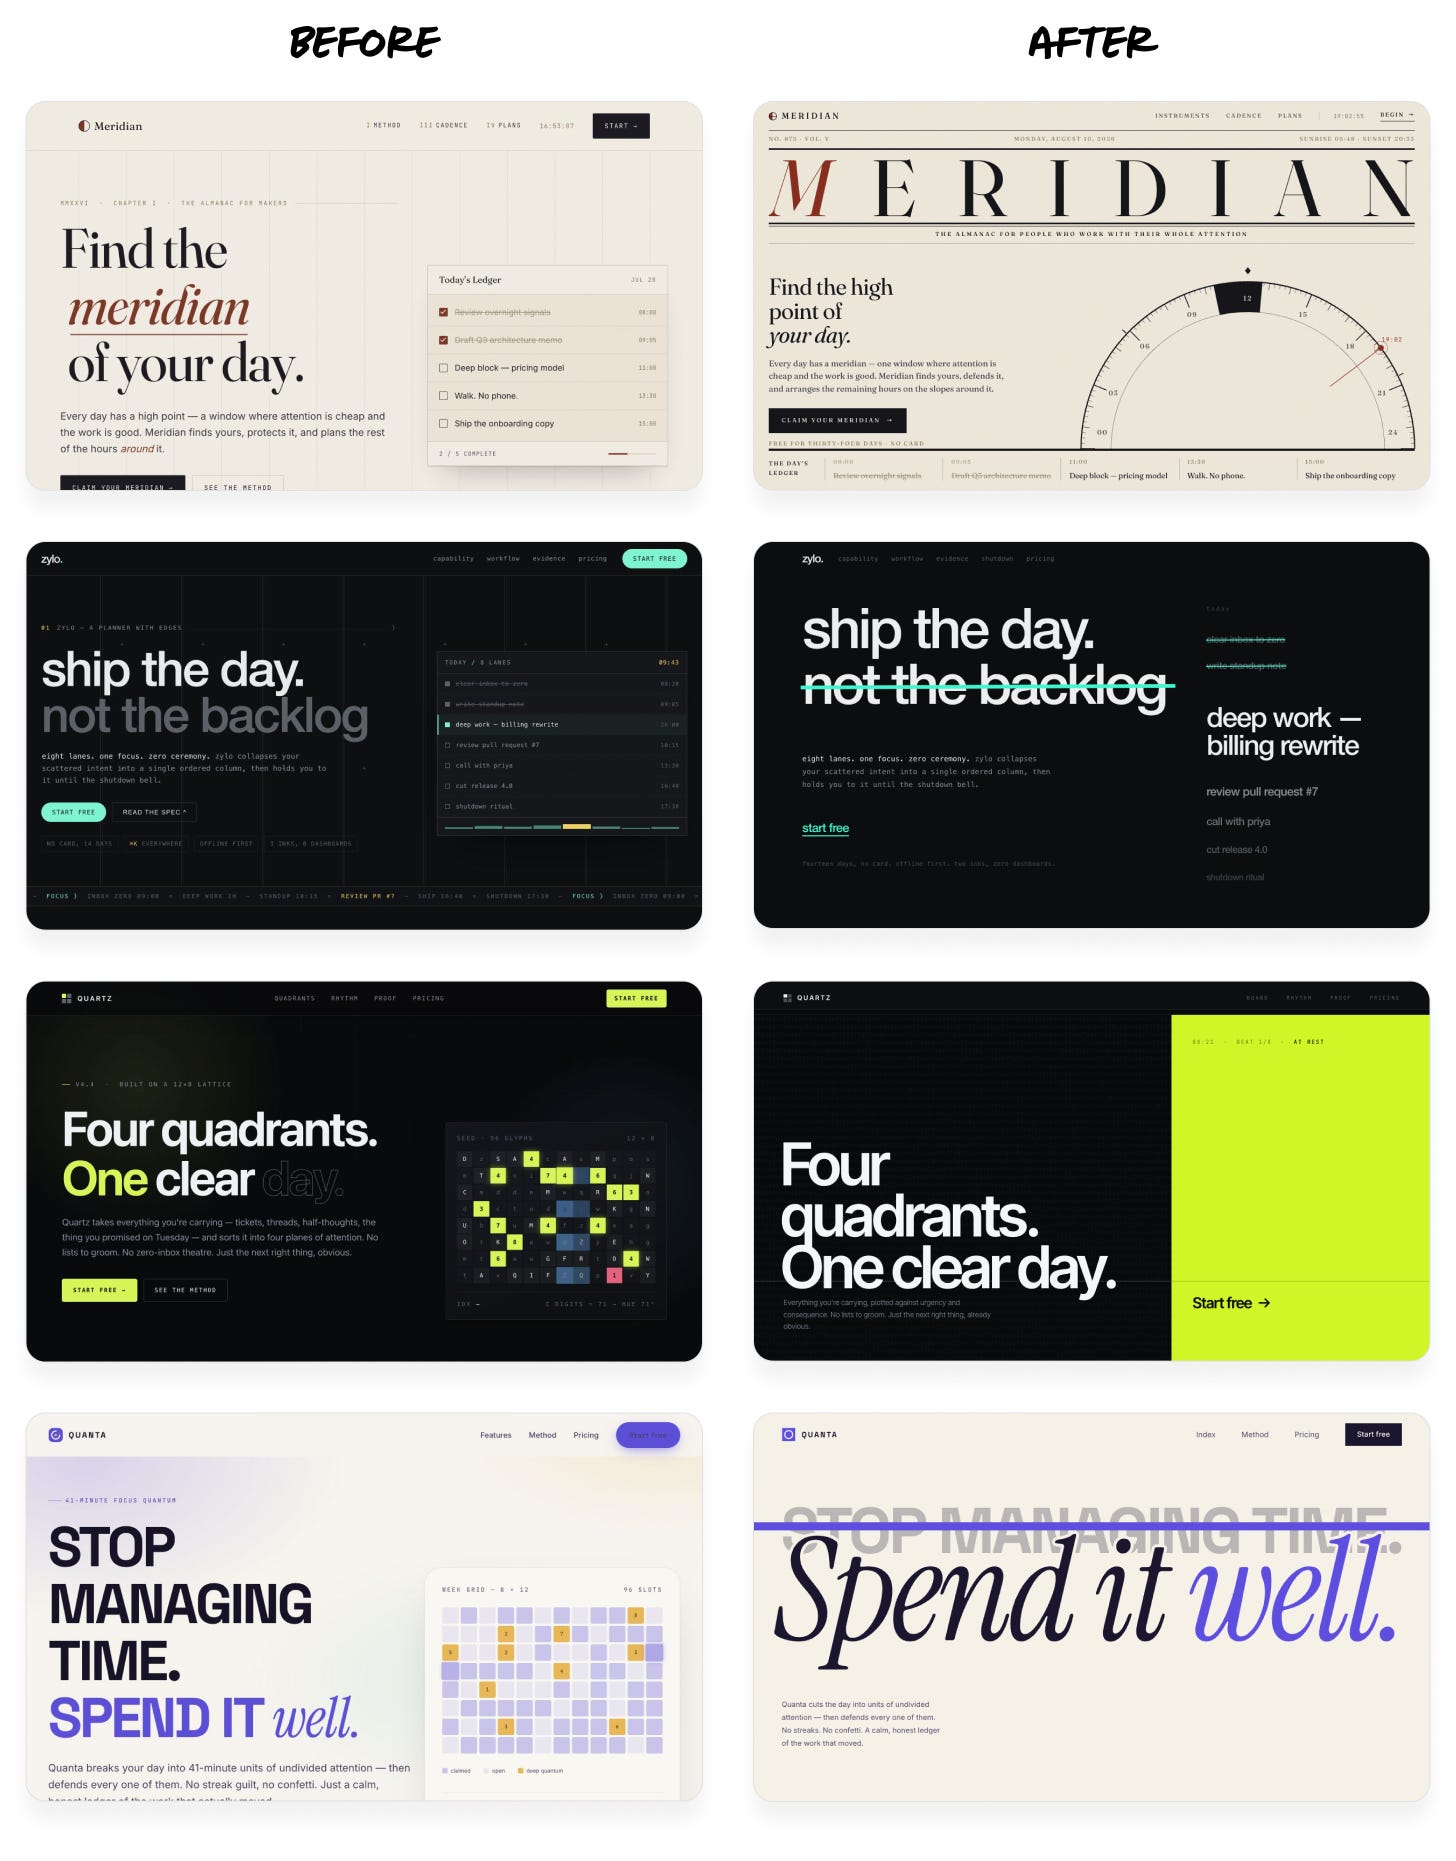
批评家 prompt 的四个关键设计(全文最值得抄的部分)
- 每次迭代都用全新上下文调用批评家,只给截图——不给代码、不给实现细节、不给之前的版本和评语。
- 批评家的思维框架:先判断设计想走什么美学路线 → 想象顶级设计工作室会如何执行这个美学 → 指出当前与那个标准之间的最大差距。
- 明确惩罚「AI 味」:过度、堆砌、一眼 AI 生成的模式要扣分;反馈要狠、要具体,不要含糊的散文。
- 成本结构的惊喜:整个流程中昂贵的大模型批评家只消耗 不到 10% 的输出 token——让 Fable 直接重画页面的成本是它的两倍还慢得多。判断贵、执行便宜,把钱花在刀刃上。
评价标准怎么写:从糟糕到优秀
| 等级 | 写法 | 问题/优点 |
|---|---|---|
| 糟糕 | 「判断设计是否漂亮、是否不像 AI 生成的。」 | 太主观,每次运行结果 wildly 不同 |
| 尚可 | 「审视我们的目标美学,想象顶级工作室如何执行,据此打分。」 | 仍然模糊,但提供了稳定框架与质量基线 |
| 优秀 | 「这里有 5 张图:4 张专业范例 + 1 张我们的产品截图。按精致度与品味排序。」 | 具体、客观,且提供了视觉基准 |
另有两条工程提醒:给批评家提供参考图(竞品截图、概念图皆可),但要声明是「基线/情绪板」而非「抄袭目标」;谨慎设置停止条件——否则批评家永远觉得不够好,执行 Agent 会在死循环里烧光 token,先跑一两轮看是否收敛。
给设计「上强度」:把图像与视频模型接进 Agent
coding agent 爱写代码,所以默认只用代码能表达的东西——渐变、形状、基础图案——而这正是「AI 生成」的最大破绽。解法:把图像生成、视频生成接到 agent 的工具链里。
- 图像:内置生图的要明确指示它用;没有的可给 OpenAI / Gemini API key(作者建议:单独建一把设了消费上限的 key,放 gitignore 的
.env.agents里,AGENTS.md 注明「仅供开发,不得随产品上线」)。 - 视频循环元素:生成纯色背景的循环视频 → 色键/视频抠像去底 → 得到一个「看不出是视频」的 UI 动画,可实现代码做不到的玻璃折射、焦散反光、复杂物理运动。
- 视频转场(被严重低估的用法):利用视频模型的关键帧插值能力,把两张产品静帧之间的过渡做成视频,随用户滚动逐帧 scrub——一个 prompt 做出苹果发布会级别的滚动叙事。
- 平台选型:视频模型迭代太快,作者用 fal.ai 这类聚合平台——给 agent 一把 key,让它自己评估挑选当下最强的模型。
Deliver:最后的 10%,全靠做减法
到了交付阶段,主角从 AI 换回人。作者的判断一针见血:「AI 热爱添加,但几乎从不删减。」过度解释、塞满无实际用途的元素,是 AI 设计最典型的指纹;而克制的设计,一眼就显得昂贵。
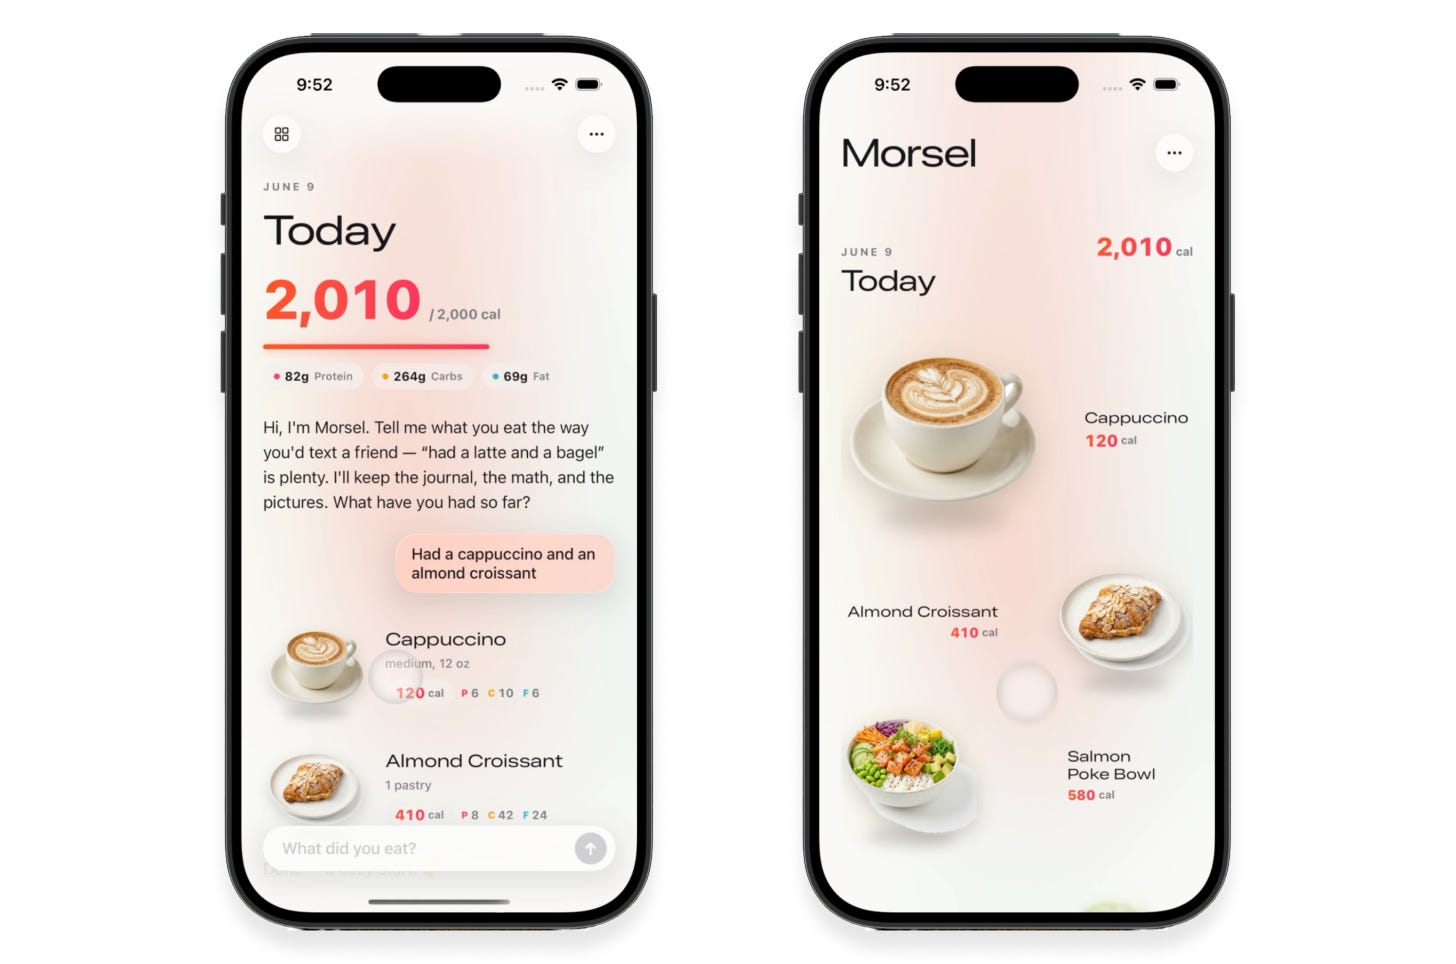
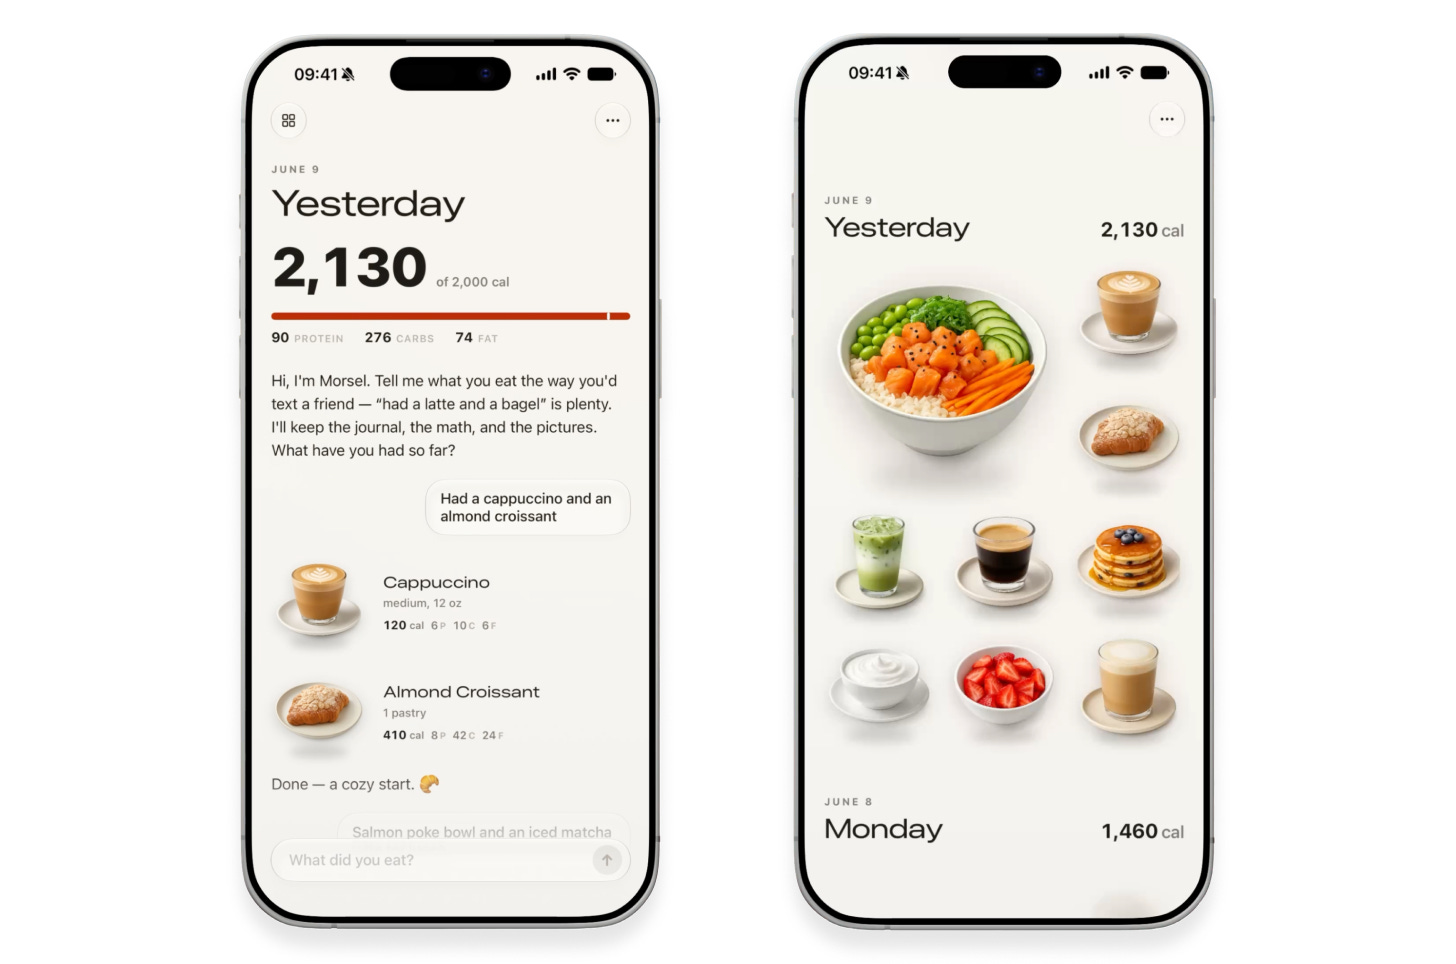
他的热量追踪 App 案例:明明要求了「干净、极简」,Claude 的初稿仍然塞满了粉色发光背景、随机高亮文字、多余的标签与空位、比 iOS 原生组件更丑的自绘控件。作者的修改指令几乎全是删除句:
深度分析:这篇文章真正在说什么
1 · 这是「管理学」文章,不是「提示词」文章
作者的身份是理解全文的钥匙:他在苹果管了 12 年人类研发团队,文中明说这套方法源自当年打破团队「界面惯性」的流程改造。他做的事本质上是把组织设计(角色分工、评审制度、质量门禁、成本控制)平移到 Agent 编排上:执行者=初级设计师,批评家=设计总监,人类=创意总监兼最终拍板。提示词技巧会过时,这套「AI 团队管理术」不会。
2 · 一个统一的理论:给确定性系统外挂熵源
全文所有技巧可以归到一张表里——LLM 缺什么,就从外部补什么:
| 模型缺的 | 外部补法 | 对应技巧 |
|---|---|---|
| 真随机性 | shell 生成的随机字符串 | SSoT 种子思维 |
| 客观眼光 | 全新上下文的第二模型 | 设计批评家闭环 |
| 视觉表达力 | 图像/视频生成 API | fal.ai / 生图接入 |
| 品味与克制 | 人类的审美判断 | Deliver 阶段做减法 |
这张表就是可迁移的方法论内核:下次遇到「AI 输出太平均」的任何任务(写文案、起名、做方案),先问——这里缺的熵,该从哪里注入?
3 · 经济学视角:判断与执行解耦
「批评家只花不到 10% token」是一个被很多人忽略的重点。它对应一个通用架构原则:把昂贵的智能用在低频、高杠杆的决策点上,把廉价的算力用在高频的执行循环里。这与现实中「总监只管关键评审、工程师负责落地」的成本结构完全同构,也是当下多 Agent 系统编排的主流范式之一。
4 · 批判性思考:这套方法的边界
- 分数会被「玩」吗?9/10 停止线是执行者视角的目标,批评家 prompt 刻意不写标准以保持客观——但长期迭代中批评家自身的品味漂移、对 prompt 措辞的敏感,仍可能让分数失真。作者也提醒「先看是否收敛再加轮次」。
- 不适用于所有场景。「独特」对消费级落地页、游戏、品牌页是资产;但对企业后台、金融表单、无障碍合规场景,「平均」恰恰是正确。这套流程服务的是需要记忆点的设计。
- 品味的门槛被抬高了。当人人都能一键生成「不错的设计」,区分度只剩人的品味与判断。作者的三步想法工作流里,②「用你的品味锐化」是唯一不可外包的环节——这篇文章真正的主角不是 AI,是 Anshu 的眼睛。
- 「AI 味」军备竞赛。当「惩罚 AI 生成模式」成为标准操作,模型也会学会规避这些模式——独特性的定义会持续移动,流程里「批评家看截图独立判断」的设定因此比任何静态清单都更耐用。
5 · 实操清单(可直接照抄)
CHECKLIST
- ☑ 探索阶段:prompt 里加「先生成随机字符串作灵感」,或直接注入一个狂野的视觉世界观。
- ☑ 让 AI 出 20 个方向 → 用你的好恶锐化 1 个 → 转成执行 prompt。
- ☑ 迭代阶段:独立批评家、全新上下文、只给截图、打 1~10 分、≥9 分停止。
- ☑ 批评标准要客观:最好给 4+1 张图做「排序题」,并给情绪板作基线。
- ☑ 大模型当批评家、快模型当执行者;给生图/视频 key 设消费上限。
- ☑ 交付阶段通读一遍只问一个问题:「这里有什么可以删?」
- ☑ 失败的 prompt 存档,新模型发布时重跑。
来源与延伸阅读
- 原文:Lenny's Newsletter — How to turn your AI into a world-class designer(2026-09-01,作者 Anshu Chimala)
- 扩展检索:Sakana AI — String Seed of Thought: Prompting LLMs for Distribution-Faithful and Diverse Generation(「LLM 能在脑中抛硬币吗」实验与 SSoT 方法)
- 方法论原型:Double Diamond 双钻设计模型(英国设计委员会 2005 年提出:Discover / Define / Develop / Deliver;本文将 Develop 并入 Define,压缩为三阶段)
- 作者阵地:Anshu Chimala 的 X / Substack / LinkedIn(持续发布 AI 设计教程与 demo)
- 工具:视频模型聚合平台 fal.ai(一把 key 调度多家视频/抠像模型)
AI 设计Prompt 工程多 Agent 编排生成-批评闭环SSoT双钻模型品味即护城河